دسترسی به API کلود (Claude) در ایران؛ Opus، Sonnet و Haiku با پرداخت ریالی
مدلهای Claude آنتروپیک را از ایران و با پرداخت ریالی صدا بزنید؛ معرفی Opus، Sonnet و Haiku در هیبانا، قیمت با تخفیف فعلی و نمونهکد آزمودهشدهٔ پایتون.
۶ دقیقه مطالعه
مدلهای Gemini گوگل را از ایران و با پرداخت ریالی صدا بزنید؛ معرفی مدلهای متنی، تصویری و امبدینگ جمینای در هیبانا، قیمت هر کدام و نمونهکد آزمودهشدهٔ پایتون.
 تیم هیبانا۶ دقیقه مطالعه
جمینای (Gemini) خانوادهٔ مدلهای هوش مصنوعی گوگل است: از مدلهای سبک و ارزان برای کارهای پرتعداد تا مدلهای Pro برای استدلال سنگین، بهعلاوهٔ مدلهای ساخت تصویر و امبدینگ. مشکل توسعهدهندهٔ ایرانی این است که API رسمی جمینای از ایران در دسترس نیست. در این مطلب میبینیم کدام مدلهای جمینای را میتوانید از طریق هیبانا و با پرداخت ریالی صدا بزنید، قیمت هر کدام در زمان نگارش این مطلب چقدر است و چطور با چند خط پایتون متن، تصویر و امبدینگ از آنها بگیرید. همهٔ کدهای این مطلب را روی API واقعی اجرا کردهایم و خروجیها واقعیاند.
گوگل در فهرست کشورهای پشتیبانیشدهٔ Gemini API نام کشورهایی را آورده که API و Google AI Studio در آنها در دسترس است و ایران در این فهرست نیست. یعنی حتی با ساختن کلید، درخواستهای ایران پذیرفته نمیشود و پرداخت هم به کارت بینالمللی نیاز دارد.
هیبانا یک درگاه سازگار با OpenAI است: برنامهٔ شما به آدرس داخلی https://api-ai.hibanacloud.ir/v1 درخواست میفرستد و هزینه از کیف پول ریالی کم میشود. برای جمینای به کتابخانهٔ جداگانهای نیاز ندارید؛ همان کتابخانهٔ openai کافی است و فقط نام مدل را عوض میکنید. اگر تازه شروع کردهاید، اول راهنمای API هوش مصنوعی و دریافت کلید API را ببینید.
فهرست زیر از کاتالوگ زندهٔ هیبانا خوانده شده است. قیمتها به تومان و بهازای هر یک میلیون توکناند و در زمان نگارش این مطلب معتبرند؛ قیمت بهروز را در صفحهٔ هر مدل ببینید.
| مدل | ورودی | خروجی |
|---|---|---|
| Gemini 3.1 Flash-Lite | ۹۵٬۰۰۰ | ۵۶۷٬۰۰۰ |
| Gemini 3.5 Flash-Lite | ۱۱۳٬۰۰۰ | ۹۴۵٬۰۰۰ |
| Gemini 3.7 Flash | ۲۸۴٬۰۰۰ | ۱٬۴۱۸٬۰۰۰ |
| Gemini 3.8 Flash | ۲۸۴٬۰۰۰ | ۱٬۴۱۸٬۰۰۰ |
| Gemini 3.5 Flash | ۵۶۷٬۰۰۰ | ۳٬۴۰۳٬۰۰۰ |
| Gemini 3.1 Pro | ۷۵۶٬۰۰۰ | ۴٬۵۳۸٬۰۰۰ |
| Gemini 3.0 Pro | ۷۵۶٬۰۰۰ | ۴٬۵۳۸٬۰۰۰ |
ویژگیهای مشترک این هفت مدل متنی طبق کاتالوگ:
کنار اینها سه مدل تصویری جمینای هم هست که گوگل آنها را با نام Nano Banana میشناساند: Nano Banana 2 Lite (gemini-3.1-flash-lite-image)، Nano Banana 2 (gemini-3.1-flash-image) و Nano Banana Pro (nano-banana-pro). یک مدل امبدینگ هم با نام Gemini Embedding 2 (gemini-embedding-2) در دسترس است.
گوگل در صفحهٔ مدلهای Gemini API مدلهای Flash-Lite را سریعترین و کمهزینهترین گزینه برای حجم بالای درخواست معرفی میکند و مدلهای Flash را برای کارهای چندمرحلهای، کدنویسی و ایجنتها. Pro ردهای است که قیمت بالاتری دارد. یک قاعدهٔ سرانگشتی برای شروع:
بهترین راه انتخاب، آزمایش روی دادههای خودتان است: یک نمونهٔ واقعی را به دو مدل بدهید و کیفیت و هزینه را کنار هم بگذارید. برای مقایسهٔ مشخصات هم مقایسهٔ Flash و Pro را ببینید.
کتابخانه را با pip install openai نصب کنید. کد همان کد همیشگی OpenAI است و فقط base_url، کلید و نام مدل فرق میکند:
from openai import OpenAI client = OpenAI( base_url="https://api-ai.hibanacloud.ir/v1", api_key="YOUR_API_KEY",) response = client.chat.completions.create( model="google/gemini-3.7-flash", messages=[ {"role": "system", "content": "کوتاه و به فارسی پاسخ بده."}, {"role": "user", "content": "در دو جمله توضیح بده پنجرهٔ متن (context window) یک مدل زبانی چیست."}, ],) print(response.choices[0].message.content)print(response.usage)خروجی در اجرای ما:
**پنجرهٔ متن** حداکثر میزان متنی (تعداد توکنهایی) است که یک مدل زبانی میتواند در یک زمان پردازش کند و به خاطر بسپارد. این ظرفیت مشخص میکند که مدل تا چه اندازه میتواند پیامهای قبلی مکالمه یا بخشهای یک متن طولانی را برای پاسخدهی در حافظه نگه دارد.CompletionUsage(completion_tokens=602, prompt_tokens=29, total_tokens=631, completion_tokens_details=None, prompt_tokens_details=None, cost_rial=8619)فیلد cost_rial هزینهٔ واقعی همین درخواست است: ۸٬۶۱۹ ریال، یعنی حدود ۸۶۲ تومان. حساب آن با جدول بالا جور است: ۲۹ توکن ورودی و ۶۰۲ توکن خروجی با قیمت Gemini 3.7 Flash. برای جزئیات این محاسبه توکن چیست و هزینهٔ API چطور حساب میشود را بخوانید.
چرا توکن خروجی از متن پاسخ بیشتر است؟
پاسخ بالا دو جمله است، اما ۶۰۲ توکن خروجی حساب شده است. طبق مستندات گوگل دربارهٔ thinking، مدلهای جمینای پیش از پاسخ «فکر» میکنند (thinking)؛ در مدلی مثل Gemini 3.8 Flash این قابلیت بهطور پیشفرض روشن است و هزینهٔ پاسخ بر اساس مجموع توکنهای خروجی و توکنهای فکر کردن محاسبه میشود. پس هنگام برآورد هزینه، فقط طول متن نهایی را در نظر نگیرید و عدد cost_rial چند درخواست واقعی را ملاک بگذارید.
همهٔ مدلهای متنی جمینای در هیبانا تصویر هم میپذیرند. در این نمونه تصویر یک فاکتور ساده را بهصورت Base64 میفرستیم و از مدل میخواهیم سه فیلد را بهصورت JSON برگرداند:
import base64from openai import OpenAI client = OpenAI(base_url="https://api-ai.hibanacloud.ir/v1", api_key="YOUR_API_KEY") with open("invoice.png", "rb") as f: image_b64 = base64.b64encode(f.read()).decode() response = client.chat.completions.create( model="google/gemini-3.7-flash", messages=[{ "role": "user", "content": [ {"type": "text", "text": "شماره، تاریخ و مبلغ کل این فاکتور را فقط بهصورت JSON با کلیدهای number، date و total برگردان."}, {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image_b64}"}}, ], }], response_format={"type": "json_object"},) print(response.choices[0].message.content)print("cost_rial:", response.usage.cost_rial)تصویر آزمایشی ما یک فاکتور انگلیسی با شمارهٔ 1047 بود و خروجی این شد:
{ "number": "1047", "date": "2026-10-05", "total": "4,800,000 IRR"}cost_rial: 7910مدل مبلغ را همانطور که در تصویر نوشته شده بود، بهصورت رشته برگرداند. اگر عدد خالص لازم دارید، یا در پرامپت صریح بگویید یا در کد خودتان تبدیلش کنید و همیشه خروجی را اعتبارسنجی کنید. جزئیات ارسال تصویر در مستندات تصویر آمده است.
مدلهای تصویری جمینای از همان endpoint ساخت تصویر سازگار با OpenAI استفاده میکنند. در هیبانا پارامتر size نسبت ابعاد است، مثل 16:9، نه اندازه به پیکسل. نشانی تصویر خروجی هم موقت است، پس باید همان لحظه آن را ذخیره کنید:
import urllib.requestfrom openai import OpenAI client = OpenAI(base_url="https://api-ai.hibanacloud.ir/v1", api_key="YOUR_API_KEY") result = client.images.generate( model="google/gemini-3.1-flash-lite-image", prompt="A ceramic teapot and two small glass cups of tea on a wooden table, soft morning light, photo", size="16:9", # در هیبانا size نسبت ابعاد است، نه پیکسل) url = result.data[0].urlurllib.request.urlretrieve(url, "tea.jpg") # لینک موقت است؛ همان لحظه ذخیره کنیدprint("saved tea.jpg")در اجرای ما فایل خروجی یک JPEG با ابعاد ۱۳۷۶ در ۷۶۸ پیکسل بود:
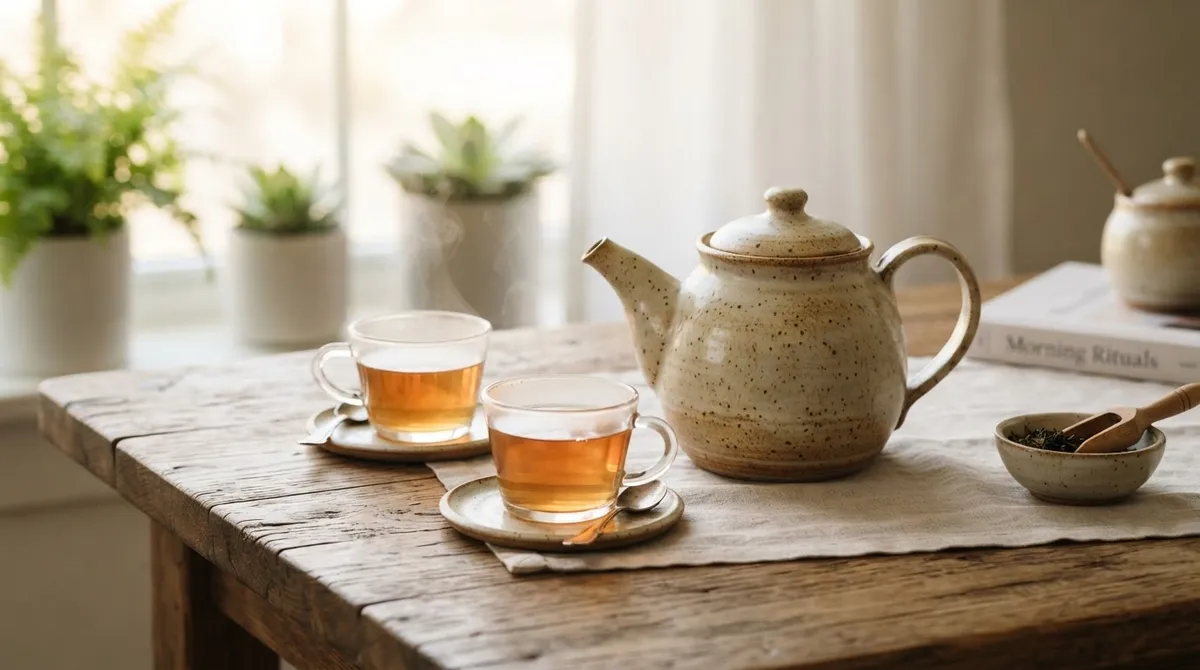
به نوشتهٔ روی جلد کتاب، سمت راست تصویر، دقت کنید: ما متنی در پرامپت نخواسته بودیم و مدل خودش آن را اضافه کرده است. اگر تصویر نباید نوشته داشته باشد، این را در پرامپت صریح بگویید. پارامترها، نسبتهای مجاز و نکتههای نوشتن پرامپت در مستندات ساخت تصویر آمده است.
برای جستوجوی معنایی و RAG به امبدینگ نیاز دارید. گوگل Gemini Embedding 2 را نخستین مدل امبدینگ چندوجهی خود معرفی میکند. در هیبانا این مدل از endpoint /v1/embeddings در دسترس است و طبق مستندات Embeddings علاوه بر متن، تصویر را هم میپذیرد؛ میتوانید متن و تصویر را در یک آیتم بفرستید و یک بردار بگیرید. پنجرهٔ ورودی این مدل در کاتالوگ ۸٬۱۹۲ توکن است و قیمت ورودی متنی آن در زمان نگارش، ۷۶٬۰۰۰ تومان برای هر یک میلیون توکن.
اگر فقط متن فارسی دارید، مدل داخلی bge-m3 هم گزینهٔ خوبی است و چون روی سرورهای خود هیبانا اجرا میشود، در قطعی اینترنت بینالملل هم کار میکند. نمونهٔ کامل آن را در آموزش RAG فارسی با bge-m3 ببینید.
برای استفاده از Gemini در ایران به VPN یا کارت خارجی نیاز ندارید: با یک کلید هیبانا و کتابخانهٔ openai، مدلهای متنی جمینای را برای چت و خواندن تصویر، Nano Banana را برای ساخت تصویر و Gemini Embedding 2 را برای امبدینگ صدا میزنید و هزینه را به ریال میپردازید. برای شروع، کلید API بگیرید، اولین درخواست را با Gemini 3.7 Flash بفرستید و اگر میخواهید جمینای را در ابزار کدنویسیتان به کار بگیرید، راهنمای اتصال ایجنتهای کدنویسی را ببینید.
مدلهای Claude آنتروپیک را از ایران و با پرداخت ریالی صدا بزنید؛ معرفی Opus، Sonnet و Haiku در هیبانا، قیمت با تخفیف فعلی و نمونهکد آزمودهشدهٔ پایتون.
۶ دقیقه مطالعه
MiMo خانوادهٔ مدلهای هوش مصنوعی شیائومی است؛ تفاوت MiMo V2.6 Flash و Pro، قیمت در هیبانا، زمان انتخاب هر کدام و نمونهکد پایتون.
۶ دقیقه مطالعه
بدون VPN و کارت خارجی از GPT، Claude و Gemini استفاده کنید و بدانید هنگام قطعی اینترنت بینالملل کدام مدلها کار میکنند؛ همراه با کد مسیر جایگزین به مدل داخلی.
۴ دقیقه مطالعه
GPT، Claude، Gemini و دهها مدل دیگر، با پرداخت ریالی و یک API سازگار با OpenAI.