دسترسی به API کلود (Claude) در ایران؛ Opus، Sonnet و Haiku با پرداخت ریالی
مدلهای Claude آنتروپیک را از ایران و با پرداخت ریالی صدا بزنید؛ معرفی Opus، Sonnet و Haiku در هیبانا، قیمت با تخفیف فعلی و نمونهکد آزمودهشدهٔ پایتون.
۶ دقیقه مطالعه
آموزش گامبهگام RAG فارسی روی اسناد خودتان با مدل امبدینگ bge-m3 و کد پایتون؛ تکهبندی، بردارسازی، جستوجوی معنایی و پاسخ مدل روی سرورهای داخلی.
 تیم هیبانا۳ دقیقه مطالعه
مدلهای زبانی دربارهٔ دنیا زیاد میدانند، اما از آییننامههای شرکت شما، مستندات محصولتان یا قراردادهایتان چیزی نمیدانند. RAG (بازیابی و تولید) سادهترین راه برای این است که مدل بر اساس اسناد خود شما پاسخ بدهد، بدون آموزش دوبارهٔ مدل. در این راهنما یک RAG فارسی کامل را با مدل امبدینگ bge-m3 و چند خط پایتون میسازیم.
ایدهٔ RAG این است که بهجای فرستادن همهٔ اسناد به مدل، فقط چند پاراگراف مرتبط با پرسش را پیدا کنید و همراه پرسش بفرستید. کار در سه قدم انجام میشود:
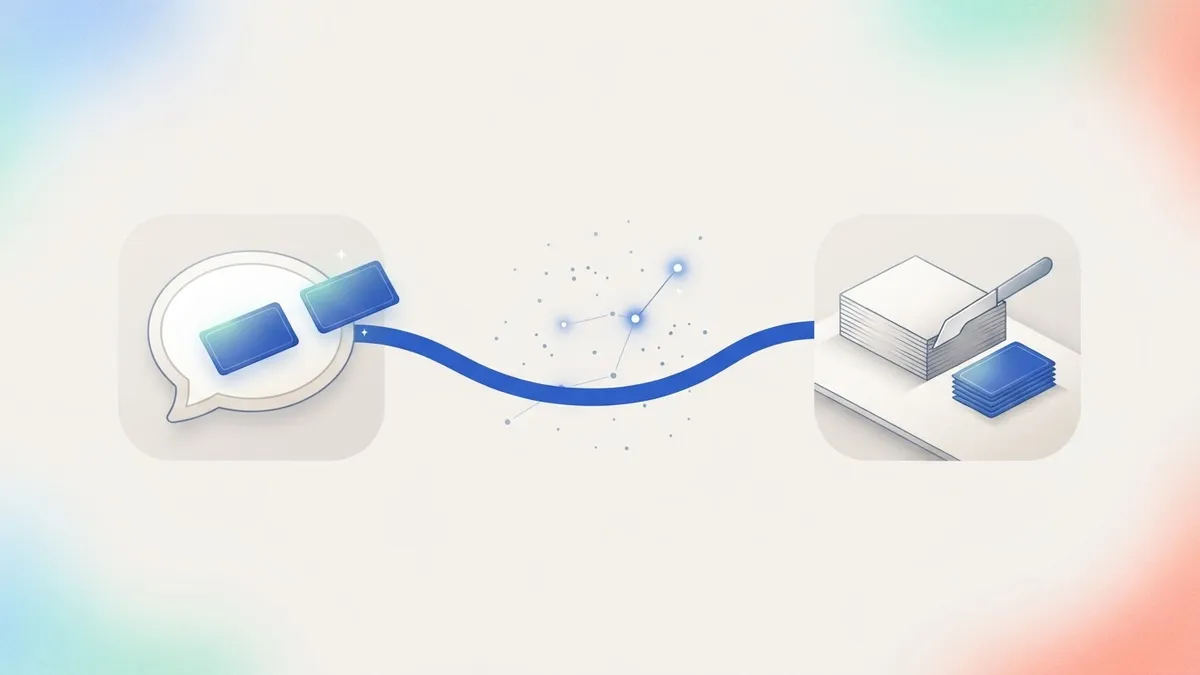
bge-m3 یک مدل امبدینگ چندزبانه است که متن فارسی را خوب میفهمد و در هیبانا با همان کلید و همان base_url همیشگی در دسترس است:
| ویژگی | مقدار |
|---|---|
| طول بردار | ۱۰۲۴ عدد |
| حداکثر طول هر ورودی | ۸۱۹۲ توکن |
| قیمت | ۱۴٬۰۰۰ تومان برای هر یک میلیون توکن |
| محل اجرا | سرورهای خود هیبانا |
نکتهٔ مهم ردیف آخر است: bge-m3 روی سرورهای هیبانا اجرا میشود و به ارائهدهندهٔ خارجی وابسته نیست. اگر برای مرحلهٔ پاسخ هم مدل داخلی GPT-OSS را انتخاب کنید، کل RAG شما بدون وابستگی به سرویسهای خارجی کار میکند. قیمتها و مشخصات بهروز را در صفحهٔ مدل bge-m3 ببینید.
فقط دو کتابخانه لازم است:
pip install openai numpyکد زیر پنج پاراگراف از یک آییننامهٔ فرضی را بردارسازی میکند، نزدیکترین تکهها را به پرسش پیدا میکند و پاسخ را از GPT-OSS میگیرد. بهجای YOUR_API_KEY کلید خودتان را بگذارید:
import numpy as npfrom openai import OpenAI client = OpenAI(base_url="https://api-ai.hibanacloud.ir/v1", api_key="YOUR_API_KEY") # ۱. اسناد شما، تکهتکه (هر تکه یک پاراگراف کوتاه)chunks = [ "مرخصی استحقاقی هر کارمند تماموقت سالانه ۲۶ روز کاری است و تا ۹ روز آن به سال بعد منتقل میشود.", "برای مرخصی استعلاجی بیش از سه روز، ارائهٔ گواهی پزشک به واحد منابع انسانی الزامی است.", "ساعت کاری شرکت از شنبه تا چهارشنبه، ۸ صبح تا ۱۶ است و پنجشنبهها دورکاری آزاد است.", "هزینهٔ اینترنت و تلفن همراه کارمندان دورکار تا سقف تعیینشده در قرارداد بازپرداخت میشود.", "حقوق هر ماه تا روز پنجم ماه بعد به حساب کارکنان واریز میشود.",] # ۲. بردار هر تکه را یک بار بسازید و نگه دارید (یک درخواست برای همهٔ تکهها)emb = client.embeddings.create(model="baai/bge-m3", input=chunks)vectors = np.array([d.embedding for d in emb.data])vectors /= np.linalg.norm(vectors, axis=1, keepdims=True) def search(question, k=2): """نزدیکترین تکهها به پرسش، با شباهت کسینوسی.""" q = client.embeddings.create(model="baai/bge-m3", input=[question]).data[0].embedding q = np.array(q) / np.linalg.norm(q) scores = vectors @ q best = np.argsort(scores)[::-1][:k] return [(chunks[i], float(scores[i])) for i in best] # ۳. پرسش کاربر → بازیابی → پاسخ مدل فقط بر اساس متن بازیابیشدهquestion = "چند روز مرخصی در سال دارم و میتوانم ذخیرهاش کنم؟"found = search(question)context = "\n".join(f"- {text}" for text, _ in found) answer = client.chat.completions.create( model="openai/gpt-oss-20b", messages=[ {"role": "system", "content": "فقط بر اساس متن زیر و به فارسی پاسخ بده. اگر پاسخ در متن نیست، بگو نمیدانم.\n" + context}, {"role": "user", "content": question}, ],) for text, score in found: print(f"{score:.3f} {text}")print("\nپاسخ:", answer.choices[0].message.content)خروجی این کد روی API هیبانا:
0.677 مرخصی استحقاقی هر کارمند تماموقت سالانه ۲۶ روز کاری است و تا ۹ روز آن به سال بعد منتقل میشود.0.524 برای مرخصی استعلاجی بیش از سه روز، ارائهٔ گواهی پزشک به واحد منابع انسانی الزامی است. پاسخ: مرخصی استحقاقی هر کارمند تماموقت سالانه **۲۶ روز کاری** است و تا **۹ روز** از این مرخصی میتوان آن را به سال بعد منتقل کرد.پرسش هیچجا کلمهٔ «استحقاقی» یا «منتقل» را نداشت، اما جستوجوی معنایی پاراگراف درست را با بیشترین امتیاز پیدا کرد و مدل فقط از همان متن پاسخ داد.
/v1/embeddings میتواند تا ۲۰۴۸ ورودی داشته باشد؛ ساختن بردارها با چند درخواست بزرگ خیلی سریعتر از هزاران درخواست تکی است.بردارسازی ارزانترین بخش کار است. با قیمت فعلی bge-m3، بردارسازیِ یکبارهٔ اسنادی به حجم تقریبی ۵۰۰ هزار توکن (چند صد صفحه متن) حدود ۷٬۰۰۰ تومان هزینه دارد. بیشتر هزینه به مرحلهٔ پاسخ مربوط است: هر پرسش حدود هزار توکن ورودی (پرسش و تکههای بازیابیشده) و چند صد توکن خروجی دارد و هزینهاش به مدل چتی که انتخاب میکنید بستگی دارد. نحوهٔ محاسبه را در مطلب توکن و هزینه توضیح دادهایم و قیمت همهٔ مدلها در لیست مدلها آمده است.
برای RAG فارسی نه به آموزش مدل نیاز دارید و نه به زیرساخت پیچیده: bge-m3 متن را به بردار تبدیل میکند، چند خط numpy نزدیکترین تکهها را پیدا میکند و یک مدل چت بر اساس همان تکهها پاسخ میدهد. جزئیات API امبدینگ را در مستندات Embeddings ببینید و اگر میخواهید RAG را بدون کدنویسی امتحان کنید، راهنمای اتصال AnythingLLM را بخوانید.
مدلهای Claude آنتروپیک را از ایران و با پرداخت ریالی صدا بزنید؛ معرفی Opus، Sonnet و Haiku در هیبانا، قیمت با تخفیف فعلی و نمونهکد آزمودهشدهٔ پایتون.
۶ دقیقه مطالعه
مدلهای Gemini گوگل را از ایران و با پرداخت ریالی صدا بزنید؛ معرفی مدلهای متنی، تصویری و امبدینگ جمینای در هیبانا، قیمت هر کدام و نمونهکد آزمودهشدهٔ پایتون.
۶ دقیقه مطالعه
بدون VPN و کارت خارجی از GPT، Claude و Gemini استفاده کنید و بدانید هنگام قطعی اینترنت بینالملل کدام مدلها کار میکنند؛ همراه با کد مسیر جایگزین به مدل داخلی.
۴ دقیقه مطالعه
GPT، Claude، Gemini و دهها مدل دیگر، با پرداخت ریالی و یک API سازگار با OpenAI.