تبدیل گفتار فارسی به متن با API؛ از پیام صوتی تا متن قابل جستوجو
فایل صوتی فارسی را با endpoint سازگار با Whisper در هیبانا به متن تبدیل کنید؛ نمونهکد پایتون و curl، پارامتر prompt، فایلهای طولانی، هزینه و محدودیتها.
۶ دقیقه مطالعه
ساخت تصویر از متن با API هیبانا؛ مدلهای تصویری، پارامتر size، دانلود فوری فایل، نوشتن prompt خوب و دو نمونهکد Python و Node.js آزمودهشده با خروجی واقعی.
 تیم هیبانا۷ دقیقه مطالعه
تصویر محصول برای فروشگاه، طرح اولیهٔ یک بنر یا تصویر شاخص برای یک مطلب وبلاگ را میشود با چند خط کد ساخت: یک توضیح متنی میفرستید و چند ثانیه بعد یک تصویر میگیرید. در این مطلب میبینیم API تولید تصویر هیبانا چطور کار میکند، کدام مدلهای تصویری در دسترساند، پارامتر size دقیقاً چه معنایی دارد و چرا باید فایل را بلافاصله دانلود کنید. هر دو نمونهکد را روی API واقعی اجرا کردهایم و تصویرها و خروجیهایی که میبینید، نتیجهٔ همان اجراها هستند؛ از جمله دو جایی که نتیجه آن چیزی نبود که انتظار داشتیم.
تولید تصویر در هیبانا از همان قالب سازگار با OpenAI استفاده میکند: یک درخواست POST به نشانی https://api-ai.hibanacloud.ir/v1/images/generations. طبق مستندات تولید تصویر با AI، درخواست سه پارامتر دارد:
| پارامتر | الزامی | معنی |
|---|---|---|
prompt | بله | توضیح تصویری که میخواهید |
model | بله | شناسهٔ مدل تصویری |
size | خیر | نسبت ابعاد تصویر، مثل 1:1 یا 16:9 |
نکتهٔ اول این است که size برخلاف عادت کسانی که با DALL-E کار کردهاند، اندازه به پیکسل (مثل 1024x1024) نیست، بلکه نسبت ابعاد است. مستندات ده نسبت را فهرست کردهاند: 1:1، 2:3، 3:4، 4:5، 9:16، 3:2، 4:3، 16:9، 21:9 و 5:4. پیشنهاد ما این است که size را همیشه صریح بفرستید تا نتیجه به پیشفرضها وابسته نباشد.
نکتهٔ دوم دربارهٔ پاسخ است: پاسخ خود فایل نیست، بلکه یک نشانی در data[0].url است که طبق همان مستندات پس از ۶۰ دقیقه منقضی میشود. اگر فقط نشانی را در پایگاه داده ذخیره کنید و پس از ۶۰ دقیقه سراغش بروید، دیگر به تصویر دسترسی ندارید. فایل را همان لحظه دانلود و در فضای ذخیرهسازی خودتان نگه دارید.
در زمان نگارش این مطلب، چهار مدل تصویری از خانوادهٔ Gemini گوگل در لیست مدلها هست. قیمت این مدلها مثل مدلهای متنی بر اساس توکن ورودی و خروجی تعریف شده است:
| مدل | قیمت هر میلیون توکن ورودی | قیمت هر میلیون توکن خروجی |
|---|---|---|
Nano Banana 2 Lite (google/gemini-3.1-flash-lite-image) | ۹۸۰٬۰۰۰ ریال | ۱۱۷٬۴۴۰٬۰۰۰ ریال |
Nano Banana 2 (google/gemini-3.1-flash-image) | ۱٬۹۶۰٬۰۰۰ ریال | ۲۳۴٬۸۸۰٬۰۰۰ ریال |
Nano Banana 2.1 (google/gemini-nano-banana-2.1) | ۵٬۸۷۰٬۰۰۰ ریال | ۱۱۷٬۴۴۰٬۰۰۰ ریال |
Nano Banana Pro (google/nano-banana-pro) | ۷٬۸۳۰٬۰۰۰ ریال | ۴۶۹٬۷۶۰٬۰۰۰ ریال |
قیمتها تغییر میکنند؛ عدد بهروز را همیشه در صفحهٔ هر مدل ببینید. طبق توضیح صفحهٔ مدلها، Nano Banana 2 Lite سریعترین و کمهزینهترین عضو این خانواده است و برای نمونهسازی و تولید پرتعداد ساخته شده، و Nano Banana Pro برای کارهای حرفهایتر مثل نوشتن متن روی تصویر و خروجی با وضوح بالاتر معرفی شده است. نمونههای این مطلب را با Nano Banana 2 Lite اجرا کردهایم. اگر میخواهید دو مدل را کنار هم ببینید، از مقایسهٔ مدلها استفاده کنید.
چون قیمت بر اساس توکن است، هزینهٔ یک تصویر را از پیش به ریال نمیتوان دقیق گفت. سادهترین راه اندازهگیری این است که موجودی کیف پول را با GET /v1/user/balance قبل و بعد از چند تصویر آزمایشی بخوانید. اگر با مفهوم توکن آشنا نیستید، توکن چیست و هزینهٔ API چطور حساب میشود را بخوانید.
مستندات توصیه میکنند prompt را به انگلیسی بنویسید. اگر کاربران شما فارسی مینویسند، میتوانید توضیح فارسی را اول با یک مدل متنی ارزان به prompt انگلیسی تبدیل کنید و بعد به مدل تصویری بدهید. کد زیر همین کار را میکند. کلید را در متغیر محیطی HIBANA_API_KEY بگذارید؛ اگر هنوز کلید ندارید، از دریافت کلید API شروع کنید.
import osimport timeimport urllib.request from openai import OpenAI client = OpenAI( api_key=os.environ["HIBANA_API_KEY"], base_url="https://api-ai.hibanacloud.ir/v1",) # ۱) توضیح فارسی را با یک مدل متنی ارزان به prompt انگلیسی تبدیل میکنیمidea = "یک فنجان چای در استکان کمرباریک کنار پنجره، صبح زود، نور ملایم، بخار چای پیداست" chat = client.chat.completions.create( model="gpt-5-nano", reasoning_effort="low", messages=[ {"role": "system", "content": ( "Rewrite the user's idea as one English prompt for an image model. " "Mention subject, setting, lighting, style and colours. " "No text or letters in the image. Reply with the prompt only." )}, {"role": "user", "content": idea}, ],)prompt = chat.choices[0].message.content.strip()print("prompt:", prompt)print("chat cost_rial:", getattr(chat.usage, "cost_rial", None)) # ۲) ساخت تصویر؛ size نسبت ابعاد است، نه پیکسلt0 = time.time()image = client.images.generate( model="google/gemini-3.1-flash-lite-image", prompt=prompt, size="16:9",)print(f"images: {len(image.data)} seconds: {time.time() - t0:.1f}") # ۳) نشانی پس از ۶۰ دقیقه منقضی میشود؛ همین حالا دانلود کنیدurllib.request.urlretrieve(image.data[0].url, "tea.png")print("saved tea.png,", os.path.getsize("tea.png"), "bytes")خروجی واقعی اجرای این کد:
prompt: A slender teacup of tea on a windowsill by a large window, early morning soft light, steam rising from the cup, cozy still-life scene, natural and warm color palette with creams, warm browns, pale yellows and soft blues.chat cost_rial: 611images: 1 seconds: 4.5saved tea.png, 130789 bytesترجمهٔ prompt با gpt-5-nano فقط ۶۱۱ ریال هزینه داشت و ساخت تصویر حدود چهار و نیم ثانیه طول کشید. این هم تصویری که برگشت:
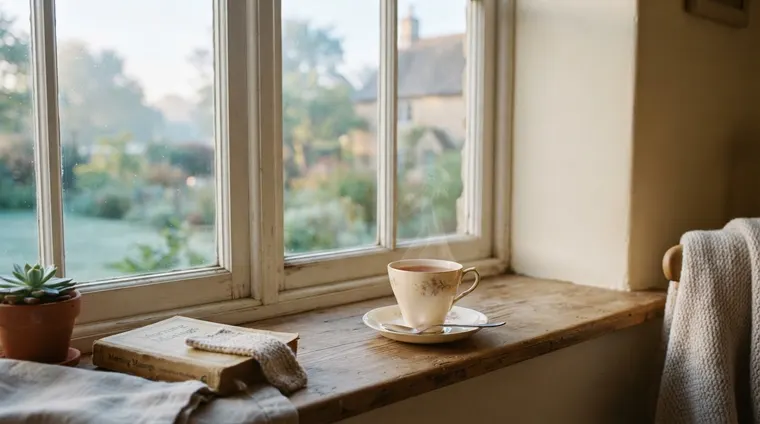
تصویر از نظر فنی خوب است، اما دو ایراد دارد که در کار واقعی هم زیاد پیش میآید.
اول، جزئیات فرهنگی در ترجمه گم شد. ما «استکان کمرباریک» خواسته بودیم و مدل متنی آن را به slender teacup ترجمه کرد؛ نتیجه یک فنجان چینی اروپایی است. مدل تصویری بر پایهٔ prompt انگلیسی تصویر میسازد و به جزئیات متن فارسی اولیه دسترسی ندارد. اگر ترجمهٔ خودکار دارید، prompt نهایی را لاگ کنید و برای مفاهیم ایرانی، نام و شکل شیء را صریح بنویسید.
دوم، دستور «متن ننویس» به مدل تصویری نرسید. روی جلد کتاب کنار پنجره یک عنوان انگلیسی دیده میشود. اگر prompt چاپشده را دوباره بخوانید، میبینید که خواستهٔ «No text» ما در آن نیامده است؛ مدل متنی آن را جا انداخته و مدل تصویری هم برای صحنهٔ «cozy» کتابی با عنوان اضافه کرده است. همیشه prompt نهایی را، نه دستوری که به مدل مترجم دادهاید، معیار قرار دهید.
این بار prompt را مستقیم به انگلیسی و با جزئیات نوشتیم: شکل لالهای استکان، نعلبکی شیشهای، حبهقند و پسزمینهٔ ساده بدون کتاب. نسبت را هم 1:1 گذاشتیم. کد با کتابخانهٔ رسمی openai برای Node.js نوشته شده است؛ راهاندازی آن را در اتصال Node.js به API هوش مصنوعی توضیح دادهایم.
import { writeFileSync } from "node:fs";import OpenAI from "openai"; const client = new OpenAI({ apiKey: process.env.HIBANA_API_KEY, baseURL: "https://api-ai.hibanacloud.ir/v1",}); const prompt = "A small clear tulip-shaped Persian tea glass (estekan) filled with dark red tea " + "on a small glass saucer, two sugar cubes beside it, on a wooden windowsill, " + "early morning soft light, visible steam, warm colours, photorealistic. " + "Plain background, no books, no text."; const image = await client.images.generate({ model: "google/gemini-3.1-flash-lite-image", prompt, size: "1:1",}); // نشانی موقت است؛ فوراً دانلود کنید و پسوند را از نوع واقعی فایل بگیریدconst res = await fetch(image.data[0].url);const type = res.headers.get("content-type") ?? "";const ext = type.includes("png") ? "png" : type.includes("webp") ? "webp" : "jpg";const bytes = Buffer.from(await res.arrayBuffer());writeFileSync(`estekan.${ext}`, bytes);console.log(type, "→", `estekan.${ext}`, bytes.length, "bytes");خروجی واقعی:
image/png → estekan.png 123140 bytes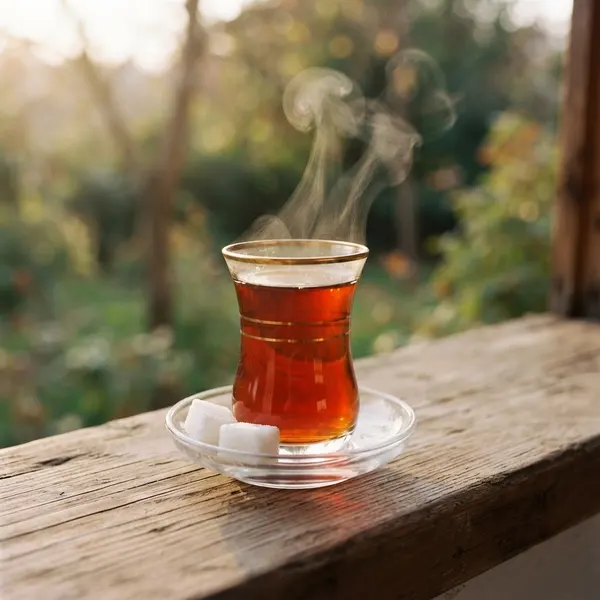
این بار هر چیزی که خواسته بودیم در تصویر هست و چیز اضافهای هم نیامده است. تفاوت دو نتیجه از مدل نیست؛ مدل یکی بود، اما نسبت ابعاد و prompt تغییر کردند.
در هر دو اجرا یک نکتهٔ فنی دیگر هم دیدیم. در نمونهٔ Python نام فایل را tea.png گذاشته بودیم و در نمونهٔ Node.js پسوند را از هدر Content-Type گرفتیم که image/png گزارش کرد. اما چند بایت اول هر دو فایل نشان داد که هر دو در واقع JPEG هستند. ابعاد هم ارزش بررسی دارد: تصویر ۱۶:۹ ما ۱۳۷۶×۷۶۸ و تصویر ۱:۱ ما ۱۰۲۴×۱۰۲۴ پیکسل بود؛ اندازهٔ دقیق پیکسلی ممکن است بین مدلها فرق کند، پس اگر برنامهتان به ابعاد مشخصی نیاز دارد، بعد از دانلود اندازه را بخوانید و در صورت نیاز تغییر اندازه دهید.
مرورگرها و نمایشگرهای تصویر معمولاً با پسوند اشتباه مشکلی ندارند، اما ابزارهایی که به پسوند یا نوع اعلامشده اعتماد میکنند، مثل بعضی کتابخانههای پردازش تصویر یا فرمهای آپلود، ممکن است فایل را رد کنند. راه مطمئن این است که نوع فایل را از «امضای» چند بایت اول آن تشخیص دهید:
import { readFileSync } from "node:fs"; // پسوند را از چند بایت اول خود فایل تشخیص میدهد، نه از هدر پاسخfunction imageExt(bytes) { if (bytes[0] === 0xff && bytes[1] === 0xd8) return "jpg"; if (bytes.subarray(0, 4).toString("latin1") === "\x89PNG") return "png"; if (bytes.subarray(8, 12).toString("latin1") === "WEBP") return "webp"; return "bin";} for (const file of process.argv.slice(2)) { console.log(file, "→", imageExt(readFileSync(file)));}اجرای آن روی دو فایلی که دانلود کرده بودیم:
estekan.png → jpgtea.png → jpgدر برنامهٔ واقعی، همین تابع را روی bytes پیش از writeFileSync صدا بزنید و نام فایل را با پسوند درست بسازید.
از این دو اجرا و راهنمای مستندات، چند قاعدهٔ ساده درمیآید:
اگر روی تصویر متن فارسی لازم دارید، ما آن را در این مطلب آزمایش نکردهایم و نتیجه را باید خودتان با دقت بررسی کنید. راه مطمئنتر این است که تصویر را بدون متن بسازید و متن را با ابزار طراحی یا کد روی آن بگذارید.
اگر درخواست خطا برگرداند، اول سه چیز را بررسی کنید: شناسهٔ مدل دقیقاً یکی از شناسههای لیست مدلها باشد، size یکی از نسبتهای مجاز باشد و موجودی کیف پول کافی باشد. کمبود موجودی با خطای ۴۰۲ و عبور از سقف تعداد درخواست با خطای ۴۲۹ برمیگردد؛ معنی هر کدام و کد تلاش دوباره را در خطاهای API هوش مصنوعی آوردهایم. سقف تعداد درخواست هر مدل در صفحهٔ همان مدل و در محدودیت نرخ درخواست آمده است؛ برای Nano Banana 2 Lite در سطح «شروع»، در زمان نگارش این مطلب ۵۰ درخواست در دقیقه است.
این مطلب فقط ساخت تصویر از متن را پوشش میدهد. اگر میخواهید تصویری را به مدل بدهید تا آن را بخواند یا توصیف کند، مسیر درست ورودی تصویر است و نمونهٔ کاملش را در ارسال تصویر و PDF به API هوش مصنوعی نوشتهایم.
ساخت تصویر با API هیبانا یک درخواست ساده به images/generations با سه پارامتر است، اما سه نکتهٔ کوچک نتیجه را تعیین میکنند: size نسبت ابعاد است، نه پیکسل، نشانی تصویر بعد از ۶۰ دقیقه از کار میافتد و باید فوراً دانلود شود، و نوع واقعی فایل را باید از خود فایل خواند. بیشترین اثر روی کیفیت هم از prompt دقیق میآید، نه از عوض کردن مدل. برای شروع، کلید API بگیرید، پارامترها و نسبتها را در تولید تصویر با AI ببینید و قیمت بهروز هر مدل را در لیست مدلها بررسی کنید.
فایل صوتی فارسی را با endpoint سازگار با Whisper در هیبانا به متن تبدیل کنید؛ نمونهکد پایتون و curl، پارامتر prompt، فایلهای طولانی، هزینه و محدودیتها.
۶ دقیقه مطالعه
چطور عکس یا PDF یک فاکتور را به API هوش مصنوعی بفرستیم و فیلدهایش را به JSON تبدیل کنیم؛ با کد پایتون آزمودهشده، خروجی واقعی و روش کنترل خطای مدل.
۶ دقیقه مطالعه
راهنمای عملی کتابخانهٔ رسمی OpenAI برای .NET با API هیبانا؛ نصب، چت، گفتوگوی چندمرحلهای، استریم، مدیریت خطا و ASP.NET Core با کد آزمودهشده.
۵ دقیقه مطالعه
GPT، Claude، Gemini و دهها مدل دیگر، با پرداخت ریالی و یک API سازگار با OpenAI.