استفاده از API هوش مصنوعی در C# و .NET با کتابخانهٔ رسمی OpenAI
راهنمای عملی کتابخانهٔ رسمی OpenAI برای .NET با API هیبانا؛ نصب، چت، گفتوگوی چندمرحلهای، استریم، مدیریت خطا و ASP.NET Core با کد آزمودهشده.
۵ دقیقه مطالعه
چطور عکس یا PDF یک فاکتور را به API هوش مصنوعی بفرستیم و فیلدهایش را به JSON تبدیل کنیم؛ با کد پایتون آزمودهشده، خروجی واقعی و روش کنترل خطای مدل.
 تیم هیبانا۶ دقیقه مطالعه
خیلی از کارهای روزمره با یک سند شروع میشوند: عکس فاکتوری که از تلگرام رسیده، PDF یک قرارداد یا اسکن یک رسید. مدلهای هوش مصنوعی امروز میتوانند اینها را بخوانند و اطلاعاتشان را به شکلی ساختاریافته برگردانند تا لازم نباشد کسی عددها را دستی در اکسل وارد کند. در این مطلب میبینیم چطور یک تصویر و یک فایل PDF را از طریق API هیبانا به مدل بفرستیم، فیلدهای یک فاکتور را به JSON تبدیل کنیم و مهمتر از همه، چطور اشتباههای مدل را پیش از ورود به سیستم بگیریم. همهٔ کدها را روی API واقعی اجرا کردهایم و خروجیها همان پاسخهایی هستند که مدل برگردانده است.
در یک درخواست معمولی Chat Completions، فیلد content پیام کاربر یک رشتهٔ ساده است. برای فرستادن سند، content به آرایهای از «بخشها» تبدیل میشود: یک بخش متنی برای دستور شما و یک بخش برای خود فایل.
| نوع سند | نوع بخش | فیلد داده | پیشوند data URI |
|---|---|---|---|
| تصویر (JPEG، PNG، GIF، WebP) | image_url | image_url.url | data:image/png;base64, |
file | file.filename و file.file_data | data:application/pdf;base64, |
فایل را میشود به دو شکل فرستاد: بهصورت Base64 داخل خود درخواست، یا با یک نشانی https عمومی که درگاه آن را دانلود میکند. طبق مستندات ورودی تصویر و ورودی فایل، روش Base64 پیشنهاد میشود، چون فایل همراه درخواست میرود و مرحلهٔ دانلودی وجود ندارد که شکست بخورد. بقیهٔ درخواست، یعنی model و messages و پارامترها، هیچ تغییری نمیکند.
همهٔ مدلها تصویر نمیبینند. در لیست مدلها، صفحهٔ هر مدل نشان میدهد ورودی تصویر را پشتیبانی میکند یا نه. در زمان نگارش این مطلب، مثلاً GPT-5 Nano، Gemini 3.7 Flash و مدلهای Claude ورودی تصویر دارند، ولی gpt-oss که روی سرورهای داخلی اجرا میشود فقط متن میپذیرد.
برای PDF، طبق مستندات ورودی فایل، پشتیبانی به ارائهدهندهٔ مدل بستگی دارد: مدلهای OpenAI، Anthropic و مدلهایی که از OpenRouter میآیند (مثل Gemini) PDF را میخوانند. اگر PDF را به مدلی بفرستید که آن را نمیپذیرد، خطای ۴۰۰ میگیرید. ما همین را با gpt-oss امتحان کردیم و این پاسخ برگشت:
{"error":{"message":"Model 'openai/gpt-oss-20b' cannot accept PDF input — the Local API has no document format. Use a model served by Anthropic, OpenAI or OpenRouter for PDFs. ...","type":"invalid_request_error","param":"messages","code":"document_input_not_supported"}}معنی بقیهٔ کدهای خطا را در خطاهای API هوش مصنوعی توضیح دادهایم.
برای آزمایش، یک فاکتور ساختگی ساختیم؛ نه فروشگاهش واقعی است و نه خریدارش. فاکتور سه ردیف کالا، جمع کل، مالیات ۱۰ درصد و مبلغ قابل پرداخت دارد:
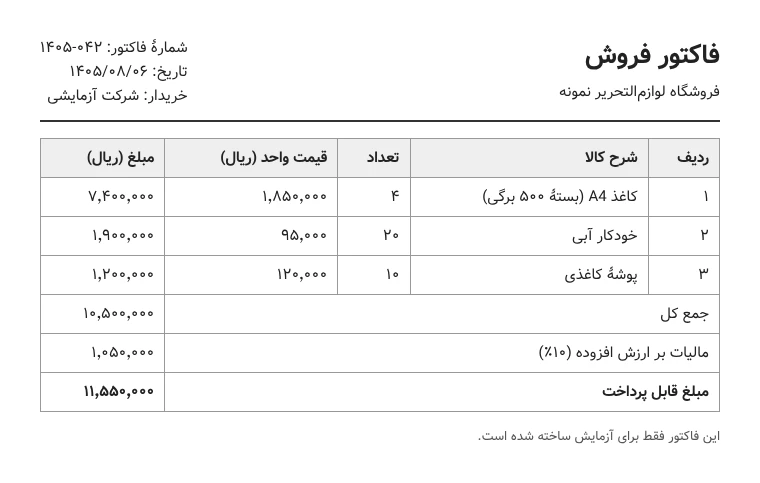
همین فاکتور را یک بار به شکل تصویر PNG و یک بار به شکل PDF ذخیره کردیم.
کد زیر تصویر را میخواند، به Base64 تبدیل میکند و از مدل میخواهد فیلدها را فقط به شکل یک شیء JSON برگرداند. با response_format={"type": "json_object"} مدل به تولید JSON معتبر ملزم میشود، اما پاسخ ناقص یا خالی همچنان ممکن است باعث خطای json.loads شود. مدل gpt-5-nano یک مدل استدلالی است و طبق مستندات، بهتر است برای پیوستها reasoning_effort="low" بگذارید تا سهم کمتری از بودجهٔ پاسخ صرف استدلال شود.
import base64import jsonimport osfrom openai import OpenAI client = OpenAI( api_key=os.environ["HIBANA_API_KEY"], base_url="https://api-ai.hibanacloud.ir/v1",) with open("invoice.png", "rb") as f: b64 = base64.b64encode(f.read()).decode() prompt = """از این فاکتور این فیلدها را استخراج کن و فقط یک شیء JSON برگردان:invoice_number, date, seller, buyer,items (آرایهای از description, quantity, unit_price, amount),subtotal, tax, total.عددها را با رقم لاتین و بدون جداکننده بنویس. اگر فیلدی در تصویر نیست، null بگذار.""" response = client.chat.completions.create( model="gpt-5-nano", reasoning_effort="low", response_format={"type": "json_object"}, messages=[{ "role": "user", "content": [ {"type": "text", "text": prompt}, {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{b64}"}}, ], }],) data = json.loads(response.choices[0].message.content)print(json.dumps(data, ensure_ascii=False, indent=2))کلید API را در متغیر محیطی HIBANA_API_KEY بگذارید؛ اگر هنوز کلید ندارید، از دریافت کلید API شروع کنید. در دستور، از مدل خواستهایم عددها را با رقم لاتین و بدون جداکننده بنویسد تا بشود مستقیم با آنها حساب کرد.
این بخش مهمترین بخش مطلب است. عددهای یک فاکتور به هم ربط دارند: حاصلضرب تعداد در قیمت واحد باید با مبلغ هر ردیف برابر باشد؛ جمع مبالغ ردیفها باید با جمع کل و جمع کل بهعلاوهٔ مالیات باید با مبلغ قابل پرداخت برابر باشد. این چند خط را به انتهای همان اسکریپت اضافه کنید:
def check_invoice(d): problems = [] for i, item in enumerate(d["items"], 1): if item["quantity"] * item["unit_price"] != item["amount"]: problems.append(f"ردیف {i}: تعداد × قیمت واحد با مبلغ نمیخواند") if sum(item["amount"] for item in d["items"]) != d["subtotal"]: problems.append("جمع ردیفها با جمع کل نمیخواند") if d["subtotal"] + d["tax"] != d["total"]: problems.append("جمع کل + مالیات با مبلغ قابل پرداخت نمیخواند") return problems problems = check_invoice(data)print("مشکلی پیدا نشد" if not problems else "\n".join(problems))print("prompt_tokens:", response.usage.prompt_tokens, "cost_rial:", getattr(response.usage, "cost_rial", None))خروجی واقعی یکی از اجراها با gpt-5-nano:
{ "invoice_number": 1405042, "date": "1405/08/06", "seller": "فروشگاه لوازم التحریر نمونه", "buyer": "شرکت آزمایشگاهی", "items": [ { "description": "کاغذ A4 (بسته 500 برگی)", "quantity": 4, "unit_price": 1850000, "amount": 7400000 }, { "description": "خودکار آبی", "quantity": 20, "unit_price": 95000, "amount": 1900000 }, { "description": "پوشه کاغذی", "quantity": 10, "unit_price": 120000, "amount": 1200000 } ], "subtotal": 10500000, "tax": 1550000, "total": 11550000}جمع کل + مالیات با مبلغ قابل پرداخت نمیخواندprompt_tokens: 663 cost_rial: 2242ردیفها و جمعها درست خوانده شدهاند، اما مالیات بهجای ۱٬۰۵۰٬۰۰۰ ریال، ۱٬۵۵۰٬۰۰۰ خوانده شده و کنترل حسابی همین را گرفته است. دو اشتباه دیگر هم هست که هیچ کنترل حسابی آنها را نمیگیرد: خریدار «شرکت آزمایشگاهی» خوانده شده در حالی که در فاکتور «شرکت آزمایشی» آمده، و شمارهٔ فاکتور بدون خط تیره و به شکل عدد برگشته است.
ما همین اسکریپت را چند بار پشت سر هم روی gpt-5-nano اجرا کردیم. عددهای ردیفها تقریباً همیشه درست بودند، ولی متنهای فارسی و شمارهٔ فاکتور از اجرایی به اجرای دیگر فرق میکرد. همان اسکریپت را دو بار هم با gemini-3.7-flash (بدون reasoning_effort) اجرا کردیم و هر دو بار همهٔ فیلدها، از جمله «۱۴۰۵-۰۴۲» و «شرکت آزمایشی»، درست برگشت. در عوض هزینهٔ هر درخواست حدود ۱۹٬۰۰۰ تا ۲۱٬۰۰۰ ریال شد، در برابر حدود ۲٬۰۰۰ تا ۳٬۰۰۰ ریال برای gpt-5-nano. این اجراها برای یک فاکتور بودهاند و نتیجهٔ یک ارزیابی کامل نیستند؛ پیش از انتخاب مدل، روی نمونههایی از اسناد خودتان آزمایش کنید.
نتیجهٔ عملی:
برای اینکه بدانید prompt_tokens چطور به هزینه تبدیل میشود، توکن چیست و هزینهٔ API چطور حساب میشود را بخوانید.
اگر فاکتور یا سند از ابتدا PDF است، لازم نیست آن را به عکس تبدیل کنید. ساختار درخواست همان است؛ فقط بخش image_url جای خود را به بخش file میدهد:
import base64import osfrom openai import OpenAI client = OpenAI( api_key=os.environ["HIBANA_API_KEY"], base_url="https://api-ai.hibanacloud.ir/v1",) with open("invoice.pdf", "rb") as f: b64 = base64.b64encode(f.read()).decode() response = client.chat.completions.create( model="gpt-5-nano", reasoning_effort="low", messages=[{ "role": "user", "content": [ {"type": "text", "text": "شماره، تاریخ و مبلغ قابل پرداخت این فاکتور چیست؟ در یک خط جواب بده."}, {"type": "file", "file": { "filename": "invoice.pdf", "file_data": f"data:application/pdf;base64,{b64}", }}, ], }],) print("prompt_tokens:", response.usage.prompt_tokens, "cost_rial:", getattr(response.usage, "cost_rial", None))print(response.choices[0].message.content)خروجی واقعی:
prompt_tokens: 1101 cost_rial: 733شماره فاکتور ۱۴۰۵-۰۴۲، تاریخ ۱۴۰۵/۰۸/۰۶، مبلغ قابل پرداخت ۱۱٬۵۵۰٬۰۰۰ ریالیک نشانهٔ ساده برای اینکه بفهمید فایل واقعاً به مدل رسیده، همین prompt_tokens است. طبق مستندات ورودی فایل، یک PDF یکصفحهای این عدد را از هزار بالاتر میبرد؛ اگر عدد در حد چند ده توکن ماند، پیوست به مدل نرسیده است، حتی اگر مدل پاسخی داده باشد. برای استخراج JSON از PDF هم میتوانید همان دستور و همان تابع check_invoice بخش قبل را به کار ببرید.
اینها را از مستندات ورودی تصویر و ورودی فایل برداشتهایم:
image/jpeg برای JPEG و image/png برای PNG.file_id کار نمیکند. فایلی که در حساب OpenAI بارگذاری شده باشد برای هیبانا قابل خواندن نیست؛ خود فایل را در file_data بفرستید.gpt-5-nano مقدار reasoning_effort را پایین نگذارید یا max_tokens را کوچک بگذارید، ممکن است همهٔ بودجه صرف استدلال شود و پاسخ خالی برگردد.محتوای سند، دستور هم هست
متن داخل تصویر یا PDF بخشی از prompt میشود. اگر اسنادی را پردازش میکنید که از بیرون میرسند، احتمال بدهید که متنی در آنها نوشته شده باشد که بخواهد رفتار مدل را عوض کند. خروجی مدل را مثل هر ورودی کاربر اعتبارسنجی کنید و اجازه ندهید مستقیم کاری انجام دهد.
فرستادن عکس یا PDF به API هوش مصنوعی فقط یک تغییر کوچک در درخواست است: content به آرایه تبدیل میشود و فایل بهصورت Base64 در بخش image_url یا file مینشیند. سختترین قسمت کار، اعتماد به خروجی است؛ مدلهای ارزان برای عددها خوب کار میکنند ولی گاهی متن فارسی را اشتباه میخوانند، پس کنترل حسابی و بررسی انسانی برای موارد مشکوک را جزو برنامه بگذارید. جزئیات فنی بیشتر در ورودی تصویر و ورودی فایل آمده است. اگر میخواهید این قابلیت را به یک ربات یا سایت وصل کنید، ساخت چتبات برای سایت و بازوی بله را ببینید و برای شروع از صفر، راهنمای API هوش مصنوعی را بخوانید.
راهنمای عملی کتابخانهٔ رسمی OpenAI برای .NET با API هیبانا؛ نصب، چت، گفتوگوی چندمرحلهای، استریم، مدیریت خطا و ASP.NET Core با کد آزمودهشده.
۵ دقیقه مطالعه
راهنمای قدمبهقدم استفاده از کتابخانهٔ رسمی openai در Node.js با API هیبانا؛ نصب، متغیر محیطی، چت، استریم و مدیریت خطا با کد آزمودهشده.
۵ دقیقه مطالعه
هر کد خطای API هیبانا یعنی چه و چه باید کرد؛ از ۴۰۱ و ۴۰۲ تا ۴۲۹ و ۵۰۰، با کد پایتون آزمودهشده برای مدیریت خطا، تلاش مجدد و بررسی موجودی.
۶ دقیقه مطالعه
GPT، Claude، Gemini و دهها مدل دیگر، با پرداخت ریالی و یک API سازگار با OpenAI.