فراخوانی تابع (Function Calling) در API هوش مصنوعی با مثال
آموزش Function Calling با API هیبانا؛ تعریف ابزار با tools، اجرای تابع در کد خودتان، حلقهٔ کامل پایتون و نتیجهٔ آزمایش روی پنج مدل.
۶ دقیقه مطالعه
یک ورکفلو واقعی در n8n که پیامهای ورودی را با مدل هوش مصنوعی در دستههای پرداخت، فنی و فروش دستهبندی میکند؛ تنظیم نودها، تست با curl و هزینهٔ هر پیام.
 ینال احمدزاده۷ دقیقه مطالعه
پیامهایی که از فرم تماس سایت، ایمیل یا پیامرسان میرسند معمولاً یک صف شلوغ میسازند: یکی مشکل پرداخت دارد، یکی خطای فنی گرفته و یکی فقط میخواهد دربارهٔ قیمت سازمانی بپرسد. در این مطلب یک ورکفلو کامل در n8n میسازیم که هر پیام را با یک مدل هوش مصنوعی میخواند، دستهاش را تشخیص میدهد و به شاخهٔ درست میفرستد. همهٔ مراحل را روی n8n نسخهٔ 2.47.3 و API واقعی هیبانا اجرا کردهایم و خروجیها و عددهایی که میبینید از همان اجرا هستند.
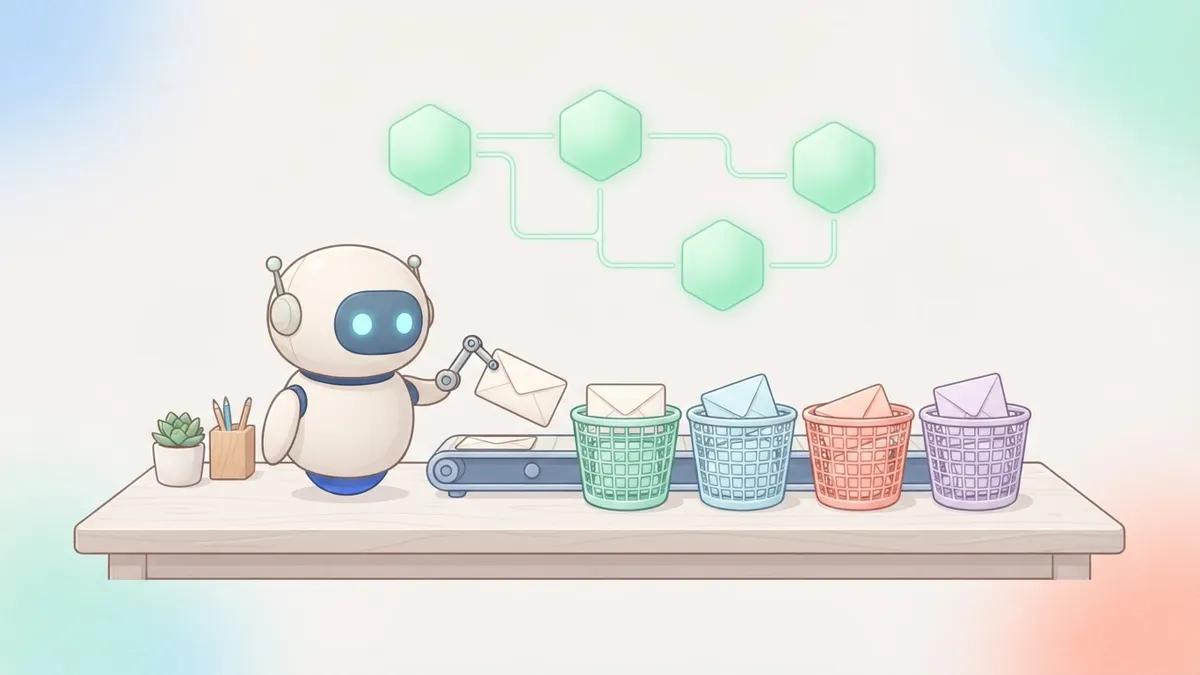
ورکفلو چهار بخش دارد:
Text Classifier برای هر دسته یک خروجی جداگانه دارد. ما سه دستهٔ billing (پرداخت)، technical (فنی) و sales (فروش) تعریف کردهایم و یک شاخهٔ Other هم برای پیامهایی که در هیچ دستهای نمیگنجند، در نظر گرفتهایم.
اگر n8n ندارید، طبق مستندات n8n سادهترین راه Docker است (خلاصهٔ دستور رسمی؛ نسخهٔ کامل با تنظیم منطقهٔ زمانی در همان صفحه است):
docker volume create n8n_datadocker run -it --rm --name n8n -p 5678:5678 -v n8n_data:/home/node/.n8n n8nio/n8nبعد http://localhost:5678 را باز کنید. ما برای این آزمون n8n را با npm نصب کردیم. مستندات n8n نسخهٔ ۲۰.۱۹ تا ۲۴ از Node.js را ذکر میکند، اما نسخهٔ 2.47.3 فقط روی Node.js 24 اجرا شد و هنگام شروع هشدار داد که اجرای n8n بیرون از کانتینر منسوخ شده است. پس اگر روی سرور نصب میکنید، همان Docker را انتخاب کنید.
برای اتصال به هیبانا یک Credential از نوع OpenAI بسازید. این Credential فیلدی به نام Base URL دارد که مقدار پیشفرض آن https://api.openai.com/v1 است. آن را به این آدرس تغییر دهید:
https://api-ai.hibanacloud.ir/v1و در فیلد API Key کلید خود را بگذارید. اگر کلید ندارید، مراحل ساخت آن در دریافت کلید API آمده است. راهنمای تصویری همین اتصال در صفحهٔ اتصال به n8n هم هست؛ این مطلب از همان نقطه ادامه میدهد.
یک نود Webhook اضافه کنید و این تنظیمات را بدهید:
POSTincoming-messageUsing 'Respond to Webhook' Nodeگزینهٔ آخر میگوید پاسخ درخواست را نود دیگری در انتهای ورکفلو میدهد. بدنهٔ JSON درخواست در خروجی Webhook زیر کلید body قرار میگیرد؛ یعنی متن پیام در $json.body.message است.
بعد از Webhook نود Text Classifier را اضافه کنید:
{{ $json.body.message }}| Category | Description |
|---|---|
billing | پرداخت، شارژ کیف پول، فاکتور، موجودی و هزینه |
technical | خطای API، مشکل اتصال، کد، کلید API و تنظیم ابزارها |
sales | سؤال پیش از خرید، همکاری، قیمت برای سازمانها |
در بخش Options گزینهٔ When No Clear Match را روی Output on Extra, 'Other' Branch بگذارید. مقدار پیشفرض آن Discard Item است؛ یعنی پیامی که به هیچ دستهای نخورد، بیصدا حذف میشود. برای صف پشتیبانی این خطرناک است، چون پیامی گم میشود و کسی متوجه نمیشود.
نام دستهها را لاتین و کوتاه نگه دارید. n8n از روی همین نامها یک قالب JSON برای پاسخ مدل میسازد و همانها برچسب خروجیهای نود هم میشوند.
Text Classifier یک ورودی Model دارد. روی آن کلیک کنید، OpenAI Chat Model را انتخاب کنید و Credential هیبانا را به آن بدهید. سه تنظیم مهماند:
gpt-5-nano را بنویسید. فهرست مدلها هم از هیبانا خوانده میشود و میتوانید از آن انتخاب کنید، اما طبق کد n8n، گزینهٔ Reasoning Effort فقط برای نام مدلهایی نشان داده میشود که با gpt-5، o1 یا یکی از o3 تا o9 شروع شوند و نامهایی مثل openai/gpt-5-nano در فهرست این شرط را ندارند.Low. برای تشخیص دسته، استدلال طولانی لازم نیست و این گزینه هزینه را کم میکند؛ عددهای آن را پایینتر میبینید.GPT-5 nano کوچکترین و سریعترین عضو خانوادهٔ GPT-5 است و برای کار سادهای مثل دستهبندی کافی است. مدلهای متنی دیگر را هم میتوانید از لیست مدلها انتخاب و با همین Credential امتحان کنید؛ فقط پیش از استفاده، دستهبندی را با چند پیام نمونه بسنجید.
به هر چهار خروجی Text Classifier یک نود Respond to Webhook وصل کنید. Respond With را روی JSON بگذارید و در Response Body برای شاخهٔ پرداخت بنویسید:
{{ { category: 'billing', message: $json.body.message } }}برای شاخههای دیگر فقط مقدار category را عوض کنید. سپس ورکفلو را Publish کنید تا آدرس Production فعال شود.
حالا چهار پیام متفاوت به آدرس Production وبهوک میفرستیم:
for m in "کیف پولم را شارژ کردم ولی موجودی هنوز صفر است" \ "هنگام فراخوانی API خطای 401 میگیرم" \ "برای شرکتمان با ۲۰ کارمند پلن سازمانی دارید؟" \ "ممنون، روز خوبی داشته باشید"; do curl -s -X POST http://localhost:5678/webhook/incoming-message \ -H "Content-Type: application/json" \ -d "{\"message\": \"$m\"}" echodoneخروجی واقعی:
{"category":"billing","message":"کیف پولم را شارژ کردم ولی موجودی هنوز صفر است"}{"category":"technical","message":"هنگام فراخوانی API خطای 401 میگیرم"}{"category":"sales","message":"برای شرکتمان با ۲۰ کارمند پلن سازمانی دارید؟"}{"category":"other","message":"ممنون، روز خوبی داشته باشید"}هر چهار پیام به شاخهٔ درست رفتند و پیام تشکر، که در هیچ دستهای نبود، به Other رسید. در تب Executions ورکفلو میتوانید پاسخ خام مدل را هم ببینید. برای پیام آخر این بود:
{"billing":false,"technical":false,"sales":false,"fallback":true}یعنی مدل برای هر دسته یک مقدار درست یا نادرست برمیگرداند و n8n بر اساس آن پیام را به خروجی مناسب میفرستد.
اگر کلید اشتباه باشد
در اولین اجرای ما کلید به Credential نرسیده بود. Text Classifier با پیام «Authorization failed - please check your credentials» متوقف شد و curl فقط {"message":"Error in workflow"} گرفت. طبق مستندات n8n، اگر پیش از رسیدن به Respond to Webhook خطایی رخ دهد، فرستنده پاسخ ۵۰۰ میگیرد. علت دقیق را در تب Executions ببینید؛ معنی کدهای خطای API را در خطاهای API هوش مصنوعی نوشتهایم.
n8n برای هر اجرا تعداد توکنهای مصرفی را در خروجی OpenAI Chat Model نشان میدهد. در آزمون ما هر پیام حدود ۵۲۰ توکن ورودی مصرف کرد؛ بیشتر آن مربوط به دستورهایی است که n8n خودش به پیام اضافه میکند؛ این دستورها فهرست دستهها و قالب JSON را هم در بر میگیرند. توکن خروجی به Reasoning Effort بستگی داشت:
| Reasoning Effort | توکن ورودی | توکن خروجی | هزینهٔ تقریبی هر پیام |
|---|---|---|---|
| پیشفرض (بدون تنظیم) | ۵۱۹ تا ۵۲۶ | ۴۱۴ | حدود ۹۱۰ ریال |
Low | ۵۱۹ تا ۵۲۶ | ۹۴ تا ۱۵۸ | حدود ۳۱۰ تا ۴۳۰ ریال |
هزینه را از روی قیمت GPT-5 nano در زمان نگارش این مطلب حساب کردهایم: ۲۶۰٬۰۰۰ ریال برای هر میلیون توکن ورودی و ۱٬۸۷۰٬۰۰۰ ریال برای هر میلیون توکن خروجی. توکن خروجی شامل توکنهای استدلال مدل هم هست و به همین دلیل از طول پاسخ کوتاه JSON بیشتر است. قیمت فعلی را در صفحهٔ GPT-5 nano ببینید و برای آشنایی با نحوهٔ محاسبه، توکن چیست و هزینهٔ API چطور حساب میشود را بخوانید.
یک نکته هم دربارهٔ گزینهٔ Enable Auto-Fixing در Text Classifier: این گزینه بهطور پیشفرض روشن است و اگر پاسخ مدل در قالب درست نباشد، n8n یک درخواست دیگر به مدل میفرستد تا آن را اصلاح کند. در آزمون ما این اتفاق نیفتاد، اما اگر هزینه را دقیق کنترل میکنید، بدانید که یک پیام ممکن است دو درخواست مصرف کند.
با یک نود Webhook، یک نود Text Classifier، یک نود OpenAI Chat Model و چهار نود Respond to Webhook یک صف پیام را بهطور خودکار دستهبندی کردیم. تنها کار لازم برای استفاده از هیبانا، تنظیم Base URL در Credential روی https://api-ai.hibanacloud.ir/v1 بود. با Reasoning Effort روی Low هزینهٔ هر پیام در آزمون ما به کمتر از نصف رسید. قدم بعدی این است که بهجای Respond to Webhook، هر شاخه را به ابزار واقعی تیم خود وصل کنید. برای شروع، راهنمای تصویری اتصال به n8n را ببینید و اگر تازه با API هوش مصنوعی آشنا میشوید، راهنمای API هوش مصنوعی نقطهٔ شروع خوبی است.
آموزش Function Calling با API هیبانا؛ تعریف ابزار با tools، اجرای تابع در کد خودتان، حلقهٔ کامل پایتون و نتیجهٔ آزمایش روی پنج مدل.
۶ دقیقه مطالعه
متن فارسی را با API هیبانا به فایل صوتی تبدیل کنید؛ آزمایش واقعی شش مدل ElevenLabs، Gemini و MiniMax با هزینه، سرعت و خواندن عدد و تاریخ، همراه نمونهکد پایتون.
۷ دقیقه مطالعه
وردپرس را به API هوش مصنوعی هیبانا وصل کنید؛ با افزونهٔ AI Engine یا یک تابع PHP آزمودهشده، همراه خلاصهٔ خودکار نوشتهها و رفع خطای cURL error 28.
۵ دقیقه مطالعه
GPT، Claude، Gemini و دهها مدل دیگر، با پرداخت ریالی و یک API سازگار با OpenAI.